定义问题的能力:决定产出的上限
有一个问题长久以来困扰着我。如果所有人都用同等级的 AI,那么区分度在哪里?如何脱颖而出,属于我的独特价值又如何体现?
品味(taste)算是一个答案,但品味来源于长时间的积累,不仅无法指引我们日常具体的工作,也无法快速提升。毕竟我们不能默念着“品味”便想做出更好的作品。
最近看了一些大佬的实践以及 Thariq(前 Anthropic 工程师)的 Blog,突然感觉有一个新的答案慢慢浮现。那便是定义问题的能力。
一、数学家的答案
这个答案其实是从数学领域迁移过来的。最近的数学家们似乎如几年前的程序员一般无助。当自己引以为傲的推导论证能力也被 AI 碾压,数学家们到底还能做什么?
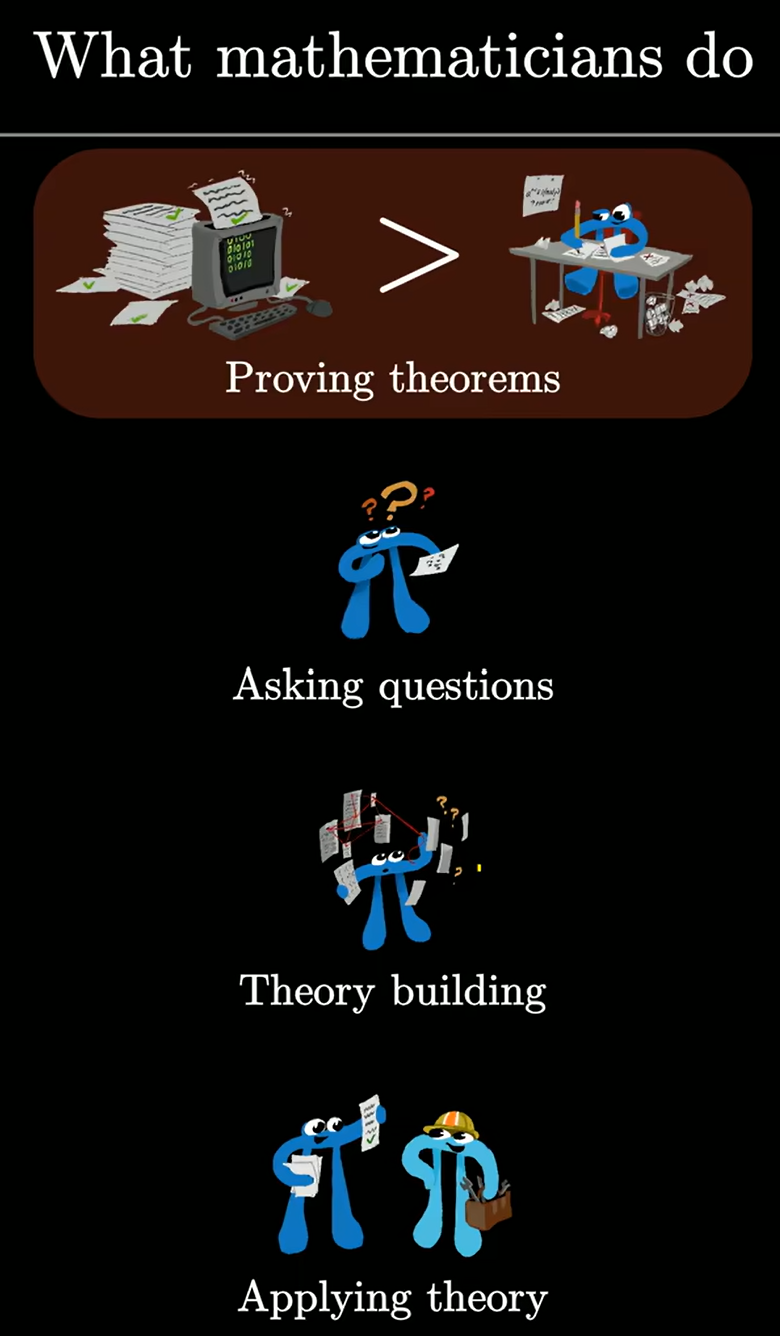
3Blue1Brown 的这期视频,把数学家的工作拆成了几块:证明定理、提出问题、建立理论、应用理论。那么数学家们还能做的工作,其中之一便是提出问题,也可以说是
定义问题
即便大模型能够证明猜想,但它还不擅长提出新猜想、新问题,推动该领域的发展。
而这个答案,我发现,并不局限在数学领域。
二、提示词工程
在 ChatGPT 刚刚问世的时候,有一个新兴领域叫做 Prompt engineering,也就是提示词工程。它想要解决的问题就是如何设计更好的提示词,从而让 AI 能够产出更好的结果。那时的模型能力仍然较弱,所以有人会设计格式化的提示词来让 AI 更懂人的需求。虽然随着模型能力的增长,这种需求已经不复存在。
但是我认为这个领域仍然有很大价值,因为写提示词本质上就是在给 AI 定义问题。让 AI 在你设定的问题框架下解决问题。定义问题的好坏很大程度上决定了最后 AI 产出的结果质量。所以如何写好的提示词,给 AI 定义清晰的问题,是今天我想讨论的关键。
不过——
学习这个领域的方式是别学习这个领域。
因为写提示词的能力不是一种可迁移的能力。
这是说,它和学习骑自行车不同。学会骑自行车后你便不会忘记如何骑自行车。但是你能在科研领域写出很好的提示词,这并不意味着你能在版面设计领域写出很好的提示词。
因为写提示词本质上是依赖于背景知识的。你能够在科研领域写出好提示词的原因是,你了解科研的步骤、目标和标准。但是你并不了解版面设计的相关背景知识,因而,即便你再了解提示词工程的原理,也无法写出版面设计领域的好提示词。
所以为了写出更好的提示词,更好地给 AI 定义问题,背景知识是关键的因素。
举两个栗子。
例子一:怎么让 AI 输出的文本更易读
之前 Andrej Karpathy 分享了自己如何让 AI 的输出更加易读。这个帖子我读后茅塞顿开。
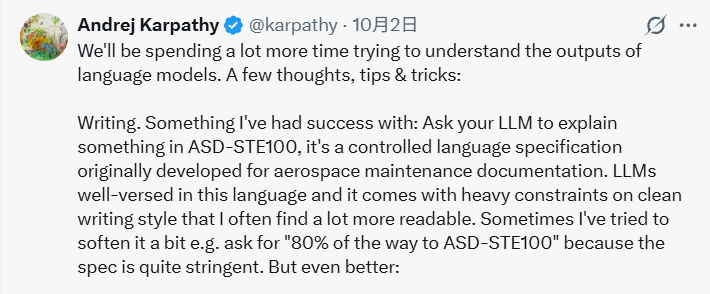
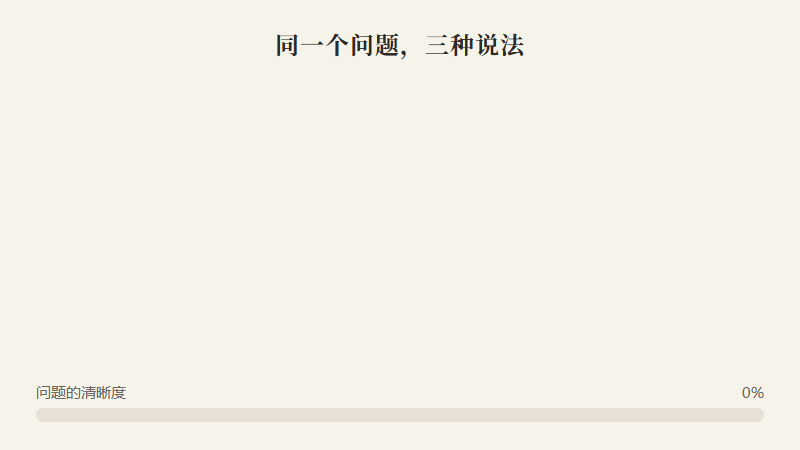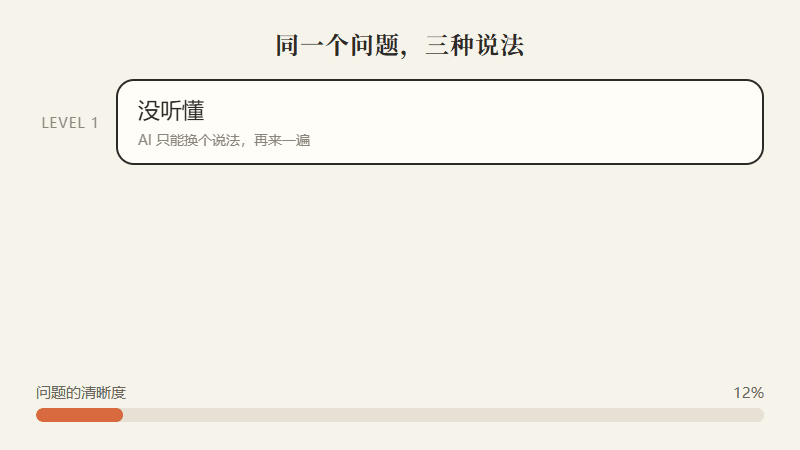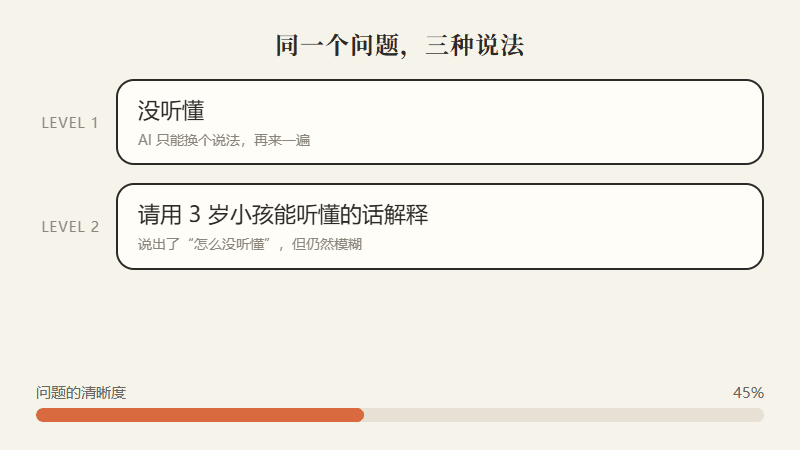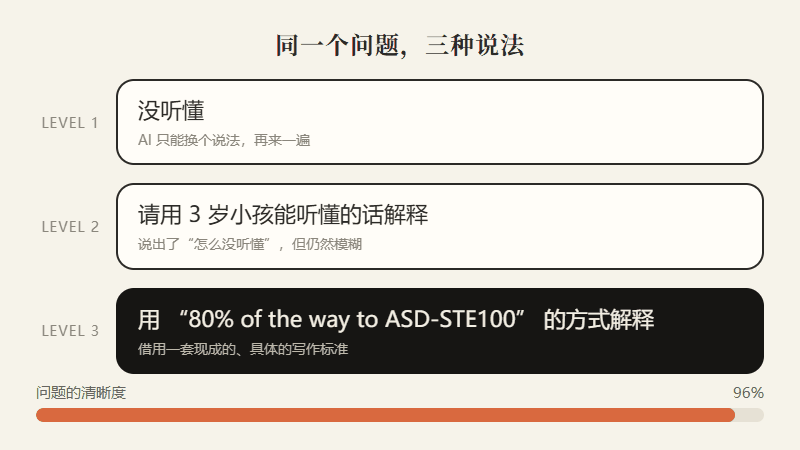
我相信,绝大多数人都曾有过感觉:AI 不说人话。虽然说的是人类的语言,怎么连起来却完全读不懂。这种情况下,大多数人可能会对 AI 说:“没听懂”,然后 AI 会用不同的、但是同样不是人话的方式再解释一遍。
更进阶一点的人会说:“请用 3 岁小孩能听懂的语言解释。”或者“我是一个智障,请用我能听懂的话来解释。”这其实已经相较于“没听懂”有很大进步,因为他尝试去给 AI 形容自己如何没听懂——自己是个智障。但是仍然不够具体。
而 AK 大神选择告诉 AI 用“80% of the way to ASD-STE100”的方式进行解释。
其中 ASD-STE100 是一个航空维修文档的语言标准,是为了让维修人员能够更好阅读文档的书写标准。它有很具体的规则,比如一个词只表示一个意思,操作步骤的每句话不超过 20 个词。这样一来,如何让 AI 的输出更加易读的问题就这样被完美定义了。这靠的是迁移已经有的标准和智慧。但如果你不知道这个标准,那么永远无法写出这样的提示词。
这种输出方式我已经写入了全局 AGENTS.md,效果很好。
例子二:怎么定义“好视频”
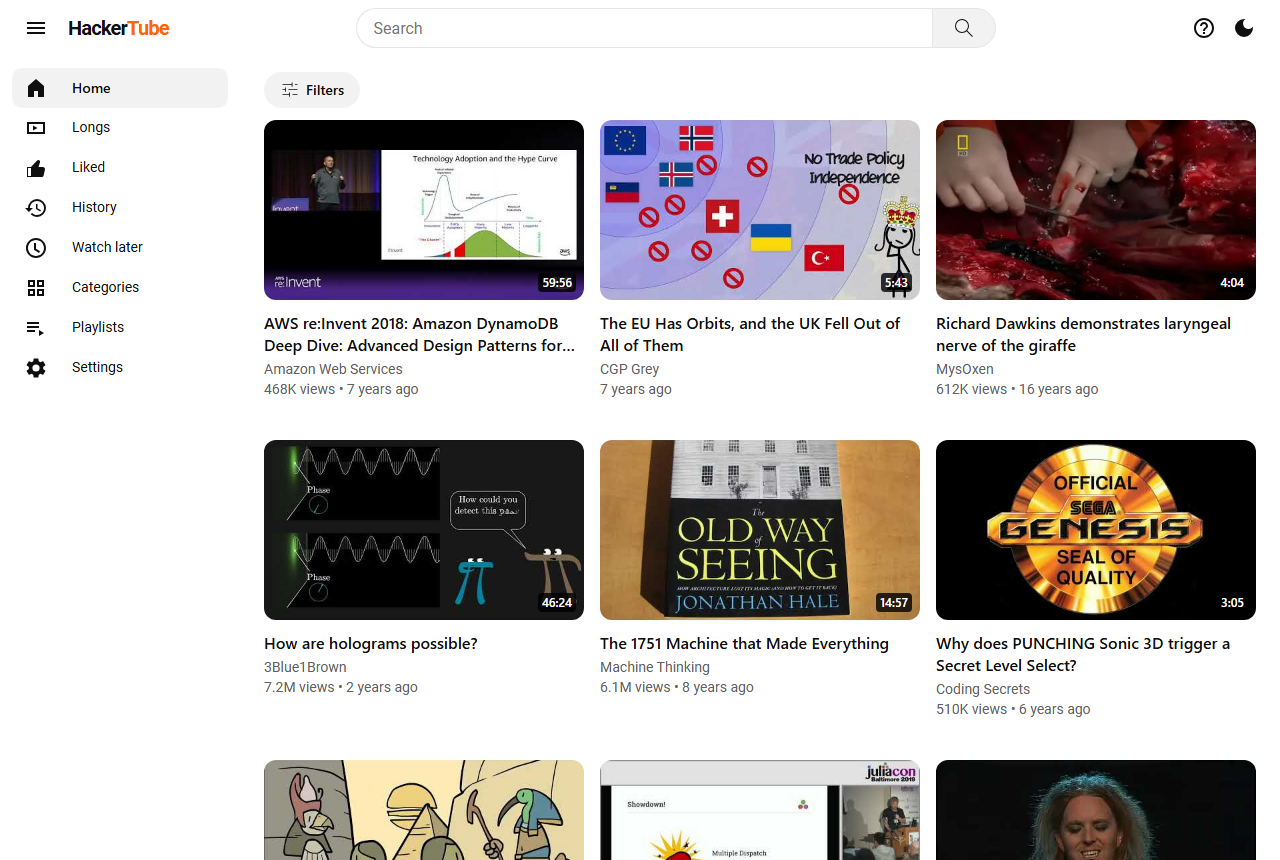
再举一个例子,AK 大神最近做了一个 HackerTube,其实就是把 YouTube 上优质的视频筛选出来,屏蔽掉低俗劣质的视频,做推荐算法的主人。
实现并不困难,但是什么样的视频才算“好”?
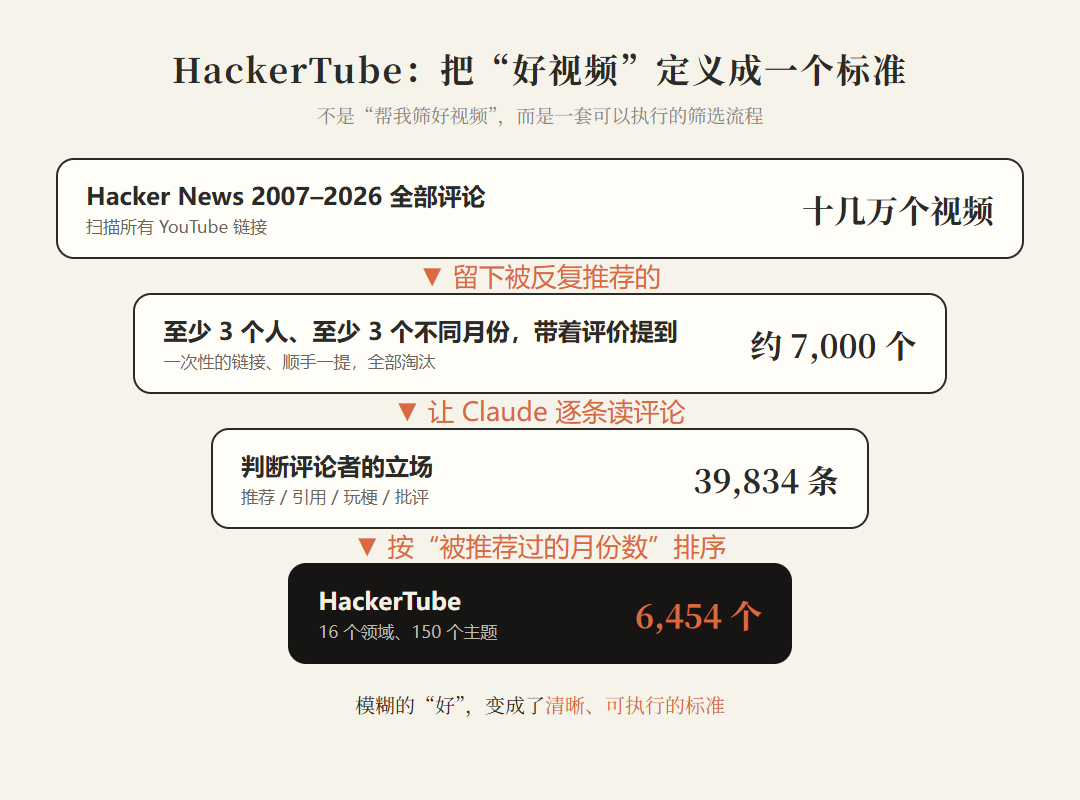
如果简单地说“筛选你觉得好的视频”,得到的只会是平均口味。AK 的做法是借用了 Hacker News 社区近二十年的沉淀:他让 Claude 读遍 HN 的完整评论存档,只保留被至少 3 个人、在至少 3 个不同月份推荐过的视频,再逐条判断评论是在推荐、引用,还是在吐槽。最终筛选出了 6,454 个视频。
“好视频”这个模糊的问题,就这样被定义成了一个清晰、可执行的标准。
其实,这样的逻辑可以推广到很多事情上。比如训练模型。强化学习的数据集怎么找?奖励怎么设计?难的不是迭代和优化,而是怎么从最开始就定义一个足够清晰的问题,这某种程度上也是 Loop engineering 的精髓。所谓 Loop engineering,就是设计一个让 AI 自己反复执行、检查、修正的闭环循环,而不是人工一轮一轮地去写提示词。
三、如何提高自己定义问题的能力?
看了前面的几个例子,你可能有一个问题。那我该如何提升自己提出问题的能力呢?
定义问题本质上就是在对未知进行建模。最近读到的 Thariq 的一篇 blog[1] 对我很有启发。
他在文章开头用了一个比喻:地图与现实地形。
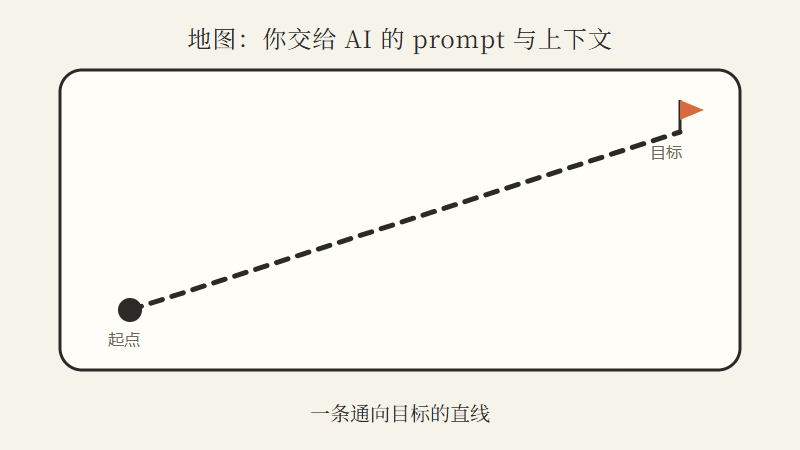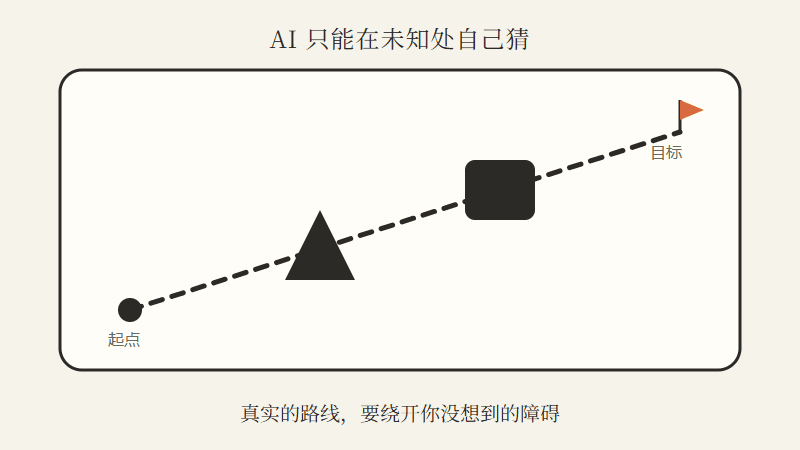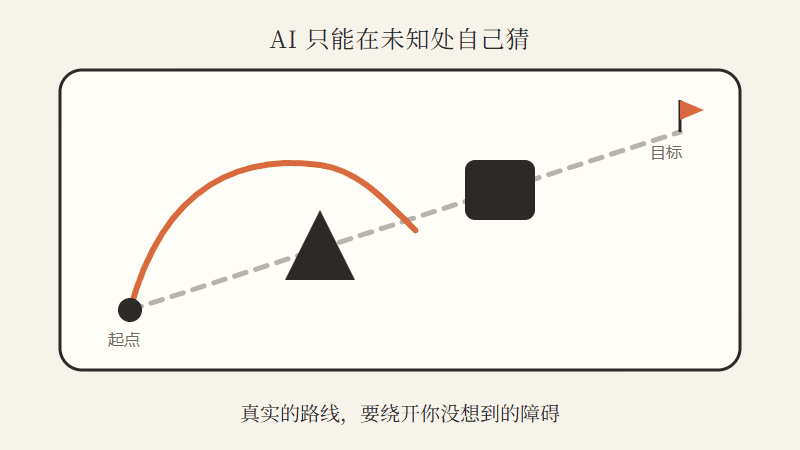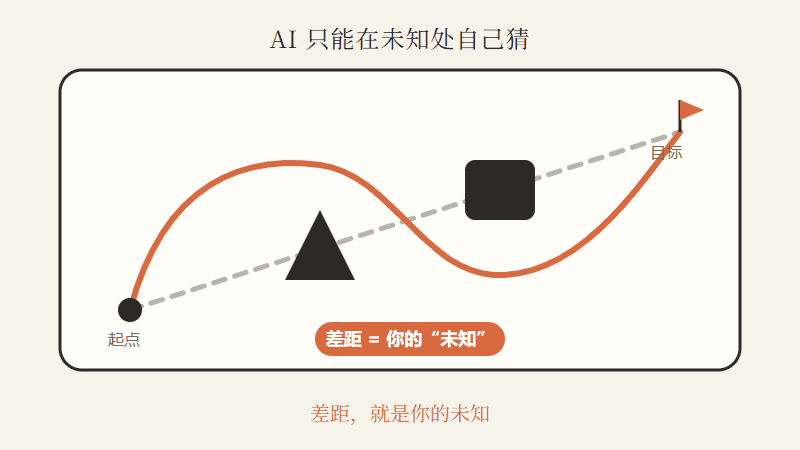
地图是我们交给 AI 的东西:prompt、skills 和上下文。地形则是工作真正发生的地方:代码库、真实世界,以及其中的实际约束。地图上是一条直线,现实里却处处要绕路。两者之间的差距,他称为“未知”(unknowns)。
AI 每碰到一个未知,就只能按它对你意图的猜测来做决定。任务越大,碰到的未知越多。他甚至说,Claude Fable 是第一个让他发现“工作质量的瓶颈,在于自己能否把未知讲清楚”的模型。
那么,未知有哪些?他分成了四类:
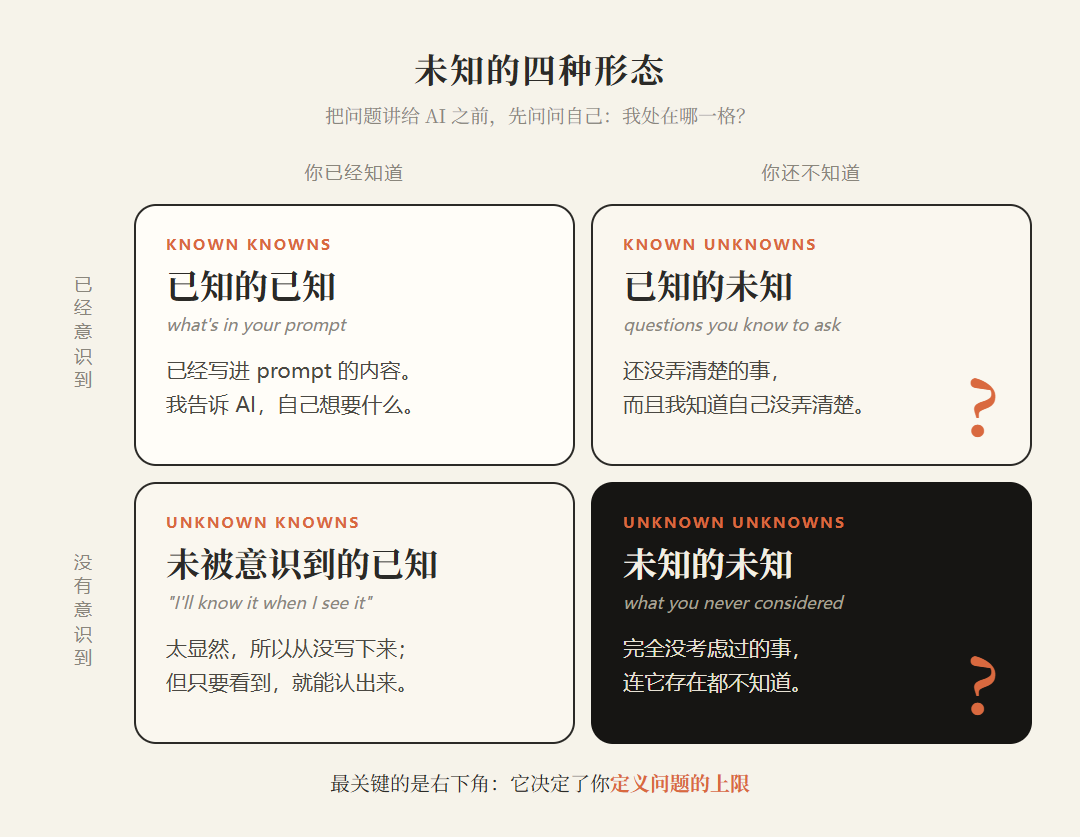
- Known Knowns(已知的已知):基本上就是我已经写进 prompt 的内容。我告诉 agent,自己想要什么?
- Known Unknowns(已知的未知):哪些事情我还没弄清楚,但我知道自己还没弄清楚?
- Unknown Knowns(未被意识到的已知):哪些事情对我来说太显然,以至于从未写下来,但只要看到就能认出来?
- Unknown Unknowns(未知的未知):哪些事情我完全没有考虑过?有哪些知识是我连其存在都不知道的?我知道一件事究竟能做到多好吗?
其中 Unknown Unknowns 最为关键,它决定了我们定义问题的上限。如果我们都不知道简洁、易读的语言标准是现成的(ASD-STE100),那么便无法用此标准定义问题。
但这样的知识自然不是与生俱来。我们可以有意识地先与 AI 讨论,补全自己这方面欠缺的知识。有如下几种方式:
1. 盲点排查(Blind spot pass)
面对一个陌生的领域,最难的往往是连该问什么都不知道。这时别急着让 AI 干活,可以先让它帮你把这方面的盲区(Unknown Unknowns)找出来。
我不懂视频调色(color grading),但现在需要给这个视频调色。你先帮我做一次盲点排查,讲讲调色有哪些我可能没考虑到的概念和问题,好让我能写出更好的 prompt
Thariq 在剪辑 Fable 的发布视频时就遇到了这种情况。他发现画面有点发灰,知道需要调色,但自己其实并不懂调色。他一开始让 Claude 直接调几个版本出来挑,结果发现自己连怎么判断好坏都不知道,于是干脆先让 Claude 给自己科普了一遍调色。
2. 头脑风暴与原型(Brainstorms and prototypes)
有些需求(比如视觉设计)很难用语言描述清楚,但只要东西摆在面前,你一眼就能看出对不对。这时候不用费劲去想怎么描述,直接让 AI 先做几个不同方向的原型,看着实物挑就行。让 AI 写个单文件 HTML 原型花不了多少时间,但如果不做原型、直接开发完再返工,就麻烦得多了。
我想给这些数据做个看板,但我没什么设计思路,也不知道能做成什么样。请先写一个 HTML 页面,展示 4 种截然不同的设计方向,我看完再给你反馈。
3. 访谈(Interviews)
大方向定了之后,细节上通常还有不少没想清楚的地方。这时可以反过来,让 AI 向你提问。不过最好加上两个限制:一是每次只问一个问题,二是先问最关键的问题——不然 AI 很容易一次抛出一大堆细枝末节的问题。
针对目前方案里任何不明确的地方来向我提问,每次只问一个问题。优先问那些我的回答会改变整体架构的问题。
除此之外,Thariq 在文章里还提到了参考资料(References)和实施计划(Implementation plan)等方法,感兴趣也可以去读原文(链接在结尾)。
结尾
了解相关知识这一步,看似拖慢了产出的进度,但实际上,这不仅减少了后续返工的情况,还拔高了产出的上限。正如 Thariq 所说:每一次讲解、头脑风暴、访谈和原型,都是在问题变得昂贵之前,用很低的成本发现自己原本不知道的东西。
回到最开始困扰我的那个问题:当所有人都用同等级的 AI,区分度在哪里?我的答案是:谁能把问题定义得更清楚。
这便是我最近的一点心得体会,希望对你有所启发!
参考资料
- Thariq Shihipar,《A field guide to Claude Fable 5: Finding your unknowns》,Anthropic,2026-07-06。
- 3Blue1Brown,《There's never been a better time to go into math》,YouTube。
- Andrej Karpathy 的帖子(X,10 月 2 日);HackerTube:https://hackertube.org